
Readiness score và recovery score khác nhau thế nào?
Mục lục
- Readiness score và recovery score khác nhau ở mục tiêu đánh giá
- Vì sao hai score dùng dữ liệu giống nhau nhưng vẫn có thể cho kết quả khác?
- Không thể đọc 80 readiness giống 80 recovery
- Khi readiness cao nhưng recovery thấp, hoặc ngược lại, nên hiểu thế nào?
- Nên ưu tiên score nào khi điều chỉnh tập luyện và nghỉ ngơi?
- Giới hạn của readiness score và recovery score
Readiness score và recovery score đều phản ánh trạng thái cơ thể trước một ngày vận động, nhưng không phải hai thang điểm chuẩn hóa. Readiness thường bao quát mức sẵn sàng dựa trên hồi phục, giấc ngủ và tải gần đây; recovery thường nhấn mạnh mức cơ thể đã hồi phục. Khác biệt thực sự nằm ở mục tiêu thuật toán, dữ liệu đầu vào, cách chuẩn hóa và cách diễn giải từng hệ thống.
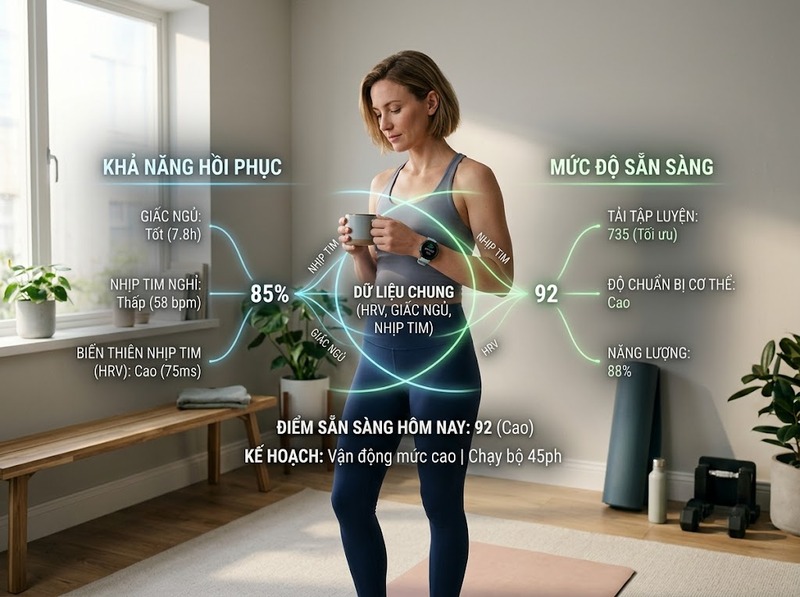
Điểm mấu chốt là không nên hiểu readiness score và recovery score như hai phép đo sinh lý độc lập. Cả hai thường là điểm tổng hợp từ dữ liệu wearable và đều dùng dữ liệu đã đo trong quá khứ để ước tính trạng thái hiện tại. Readiness thiên về câu hỏi “hôm nay cơ thể sẵn sàng chịu tải đến đâu?”, còn recovery thiên về “cơ thể đã hồi phục đến mức nào sau tải và stress trước đó?”. Trong nhiều hệ thống, hai khái niệm chồng lấn mạnh; thậm chí một chỉ số mang tên “recovery” có thể được dùng chính để quyết định mức sẵn sàng cho ngày mới.
Readiness score và recovery score khác nhau ở mục tiêu đánh giá
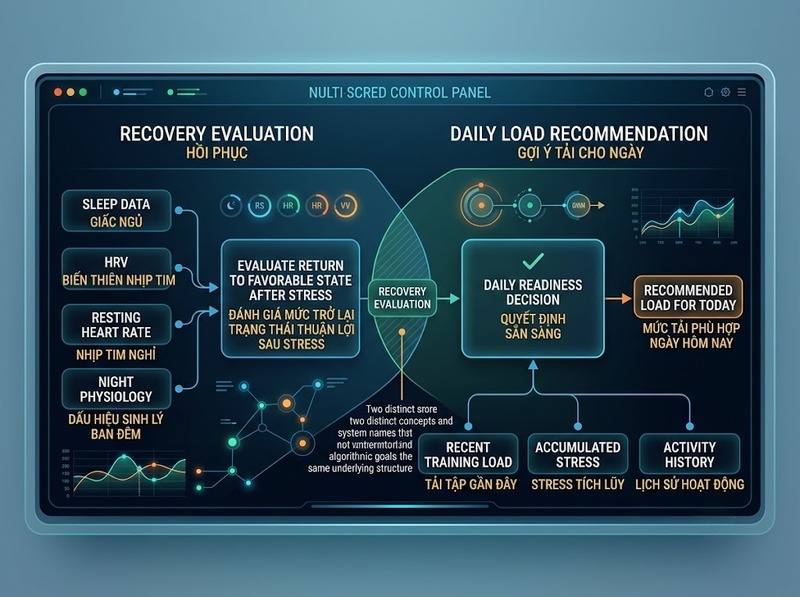
Readiness score thường là lớp tổng hợp rộng hơn. Nó cố gắng biến nhiều tín hiệu thành một câu trả lời mang tính hành động: hôm nay có phù hợp để tập nặng, làm việc cường độ cao hay nên giảm tải? Vì vậy, ngoài các dấu hiệu hồi phục sinh lý, mô hình readiness có thể tính thêm tải vận động gần đây, lịch sử ngủ, stress hoặc thời gian phục hồi còn lại.
Recovery score tập trung hơn vào mức cơ thể đã quay về trạng thái thuận lợi sau stress. Các tín hiệu thường xoay quanh HRV, nhịp tim nghỉ, giấc ngủ và những thay đổi sinh lý ban đêm. Tuy nhiên, đây chỉ là xu hướng về cách đặt tên, không phải quy ước bắt buộc. Một hãng có thể gọi điểm tổng hợp dùng để hướng dẫn tải ngày hôm nay là “Recovery”, trong khi hãng khác gọi một chỉ số có chức năng rất gần là “Readiness”.
|
Khía cạnh |
Readiness score |
Recovery score |
|
Câu hỏi chính |
Hôm nay sẵn sàng chịu tải đến đâu? |
Cơ thể đã hồi phục đến mức nào? |
|
Phạm vi thường gặp |
Hồi phục giấc ngủ tải gần đây stress/bối cảnh |
Tín hiệu hồi phục sinh lý giấc ngủ |
|
Vai trò |
Hỗ trợ quyết định mức tải trong ngày |
Cho biết trạng thái phục hồi trước khi nhận tải mới |
|
Quan hệ giữa hai chỉ số |
Có thể dùng recovery như một thành phần của readiness |
Có thể được thiết kế như một chỉ số readiness dù tên là recovery |
Vì thế, câu “readiness rộng hơn recovery” hữu ích như một mô hình tư duy, nhưng không nên dùng như định nghĩa tuyệt đối. Muốn biết một score thực sự đo gì, cần xem chính các contributor và cách hãng mô tả mục tiêu của score đó.
Vì sao hai score dùng dữ liệu giống nhau nhưng vẫn có thể cho kết quả khác?
Điểm tổng hợp không chỉ phụ thuộc vào dữ liệu nào được đưa vào mà còn phụ thuộc vào cách dữ liệu được xử lý. Hai thuật toán đều có thể dùng HRV, nhịp tim nghỉ và giấc ngủ nhưng cho kết quả khác nếu chúng đặt trọng số khác nhau, dùng cửa sổ thời gian khác nhau hoặc so với baseline cá nhân theo cách khác nhau.
Ví dụ, một mô hình có thể phản ứng mạnh với HRV của đêm vừa rồi, trong khi mô hình khác coi xu hướng nhiều ngày quan trọng hơn. Một readiness score cũng có thể giảm vì tải tập tích lũy hoặc stress gần đây dù các chỉ số qua đêm không xấu. Ngược lại, một recovery score có thể nhạy hơn với biến động sinh lý qua đêm và ít bị chi phối bởi lịch sử tải dài hơn.
Thời điểm cập nhật cũng tạo khác biệt. Có score chủ yếu được chốt sau giấc ngủ, trong khi score khác có thể được cập nhật khi trạng thái tải hoặc stress trong ngày thay đổi. Vì vậy, hai điểm được xem vào cùng một giờ chưa chắc đang dùng cùng “ảnh chụp” dữ liệu.
Một lớp khác là thuật toán độc quyền. Các hãng thường công khai những nhóm dữ liệu chính nhưng không công khai đầy đủ trọng số, xử lý nhiễu hoặc logic kết hợp. Do đó, không có công thức chung để chuyển một recovery score thành readiness score hay ngược lại.
Không thể đọc 80 readiness giống 80 recovery
Nhiều wearable đưa score về thang 0–100, nhưng cùng một con số không tạo ra cùng một ý nghĩa. Mốc phân loại “thấp”, “trung bình”, “tốt” hay “cao” do từng hệ thống tự định nghĩa; cách hiệu chỉnh theo baseline cá nhân cũng khác nhau. Vì vậy, 80/100 trên một readiness score không tương đương 80/100 trên một recovery score của ứng dụng khác.
Cách đọc hữu ích hơn là so điểm với chính lịch sử của nó. Một người có readiness dao động quanh 75–85 trong nhiều tuần sẽ hiểu tín hiệu khác với người thường ở 90–95 rồi đột ngột giảm xuống 75. Cùng lúc, contributor nào kéo điểm xuống thường quan trọng hơn việc score giảm chính xác bao nhiêu điểm.
|
Cách đọc dễ sai |
Cách đọc phù hợp hơn |
|
So 80 readiness với 80 recovery như cùng một đơn vị |
So từng score với baseline và vùng phân loại của chính hệ thống đó |
|
Chỉ nhìn điểm tổng |
Xem HRV, nhịp tim nghỉ, ngủ, tải hoặc stress nào đang kéo score |
|
Phản ứng mạnh với một ngày |
Ưu tiên xu hướng nhiều ngày và mức thay đổi có bối cảnh |
|
So điểm giữa hai người |
Ưu tiên diễn biến trong cùng một người, cùng thiết bị và cùng cách đo |
Điều này cũng giải thích vì sao không nên lấy trung bình hai score từ hai ứng dụng. Phép tính đó tạo ra một con số mới nhưng không có ý nghĩa sinh lý được chuẩn hóa.
Khi readiness cao nhưng recovery thấp, hoặc ngược lại, nên hiểu thế nào?
Nếu hai điểm đến từ hai thiết bị hoặc hai ứng dụng khác nhau, sự lệch nhau trước hết phản ánh khác biệt mô hình chứ chưa chứng minh một bên “đúng” và bên kia “sai”. Cần truy ngược xuống contributor: giấc ngủ, HRV, nhịp tim nghỉ, tải gần đây, stress và cửa sổ dữ liệu nào đang tạo ra chênh lệch.
Trường hợp recovery tương đối tốt nhưng readiness thấp có thể xảy ra khi tín hiệu qua đêm đã trở lại gần baseline nhưng mô hình readiness vẫn thấy tải tích lũy, stress gần đây hoặc thiếu cân bằng hoạt động. Ý nghĩa thực tế là “đã hồi phục một phần” chưa chắc đồng nghĩa “nên nhận thêm tải lớn ngay hôm nay”.
Chiều ngược lại — readiness cao nhưng recovery thấp — cần đọc thận trọng hơn, đặc biệt khi hai score đến từ hệ thống khác nhau. Một thuật toán có thể đặt trọng số thấp hơn cho biến động sinh lý vừa xuất hiện, dùng cửa sổ dài hơn hoặc cập nhật ở thời điểm khác. Nếu cảm giác mệt, đau bất thường hoặc các chỉ số nền như HRV và nhịp tim nghỉ lệch rõ so với thường ngày, không nên dùng một readiness score cao để phủ nhận các tín hiệu đó.
Khi hai score mâu thuẫn, mục tiêu không phải chọn “điểm thắng”. Mục tiêu là xác định nguyên nhân bất đồng và xem yếu tố nào liên quan trực tiếp đến tải bạn đang định thực hiện.
Nên ưu tiên score nào khi điều chỉnh tập luyện và nghỉ ngơi?
Nếu bạn chỉ dùng một hệ sinh thái, hãy ưu tiên score mà nền tảng đó thiết kế làm chỉ số quyết định chính và đọc kèm contributor. Một score tổng hợp có giá trị nhất khi nó giúp rút gọn nhiều dữ liệu thành hành động, nhưng quyết định cuối cùng vẫn phải khớp với loại buổi tập, tải đã tích lũy và cảm nhận thực tế.
Nếu bạn dùng nhiều ứng dụng, có thể phân vai thay vì cố hợp nhất điểm. Readiness hữu ích cho câu hỏi rộng “hôm nay nên nhận mức tải nào?”, còn recovery hữu ích để kiểm tra “các tín hiệu hồi phục đang ở trạng thái nào?”. Hai câu trả lời bổ sung cho nhau khi chúng được giữ đúng ngữ cảnh.
Một cách ra quyết định thực tế là đi từ dưới lên: xem có dấu hiệu bất thường rõ ràng hay không, kiểm tra contributor quan trọng, nhìn xu hướng vài ngày, rồi mới dùng score tổng hợp để điều chỉnh cường độ. Điểm cao không tự động có nghĩa nên tập tối đa; điểm thấp cũng không bắt buộc phải nghỉ hoàn toàn. Tải phù hợp còn phụ thuộc mục tiêu buổi tập và mức độ lệch khỏi baseline.
Giới hạn của readiness score và recovery score
Cả readiness score và recovery score đều là ước tính tổng hợp từ dữ liệu cảm biến và thuật toán, không phải xét nghiệm lâm sàng. Chất lượng tín hiệu có thể thay đổi theo cách đeo thiết bị, dữ liệu bị thiếu hoặc điều kiện đo; còn thuật toán có thể xử lý cùng một tín hiệu theo cách khác nhau. Một thay đổi của score vì thế không tự cho biết nguyên nhân duy nhất phía sau nó.
Đó là lý do contributor quan trọng khi score đi ngược cảm nhận thực tế. Điểm thấp có thể đến từ giấc ngủ, HRV, nhịp tim nghỉ, tải gần đây hoặc nhiều yếu tố cùng lúc; chỉ nhìn score tổng không cho biết yếu tố nào cần được điều chỉnh. Tương tự, một điểm cao không loại trừ việc dữ liệu đầu vào thiếu hoặc chưa phản ánh một thay đổi mới xảy ra.
Vì vậy, các score này phù hợp nhất với vai trò hỗ trợ quyết định, không phải “phán quyết” duy nhất về sức khỏe hay khả năng vận động. Khi score và trạng thái thực tế liên tục không khớp, nên kiểm tra chất lượng dữ liệu, contributor và cách hệ thống định nghĩa score trước khi dựa vào con số đó để tăng tải.
Readiness score và recovery score khác nhau chủ yếu ở câu hỏi mà thuật toán cố trả lời, không phải ở một ranh giới sinh lý tuyệt đối. Readiness thường bao quát mức sẵn sàng nhận tải, còn recovery thường nhấn mạnh mức hồi phục; nhưng cách đặt tên giữa các hãng có thể chồng lấn. Vì mỗi hệ thống dùng dữ liệu, trọng số, baseline và ngưỡng diễn giải riêng, cách dùng đúng là theo dõi xu hướng trong cùng hệ sinh thái, đọc contributor phía sau score và tránh so trực tiếp các con số 0–100 giữa các nền tảng.

GỬI Ý KIẾN BÌNH LUẬN
