AI nhận diện lỗ chân lông hoạt động như thế nào?
Mục lục
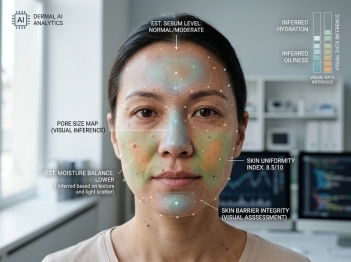
AI nhận diện lỗ chân lông không chỉ tìm các chấm tối trên da. Hệ thống kết hợp độ tương phản, hình dạng, kích thước, vị trí và dữ liệu học máy để tạo bản đồ lỗ chân lông, sau đó tính số lượng, kích thước và mật độ trong vùng ảnh đã chuẩn hóa.
Trên ảnh da đủ rõ, lỗ chân lông thường tạo ra những cấu trúc nhỏ có độ tương phản khác vùng da xung quanh; nhiều trường hợp chúng trông tối hơn do bóng và hình học bề mặt. Từ tín hiệu này, hệ thống tìm các vùng ứng viên, kiểm tra hình thái và thang kích thước, rồi phân đoạn những vùng có khả năng là lỗ chân lông. Mô hình học sâu chủ yếu nhận dạng bằng đặc trưng học từ dữ liệu, còn hệ thống truyền thống dựa nhiều hơn vào bộ lọc, ngưỡng và quy tắc hình học.
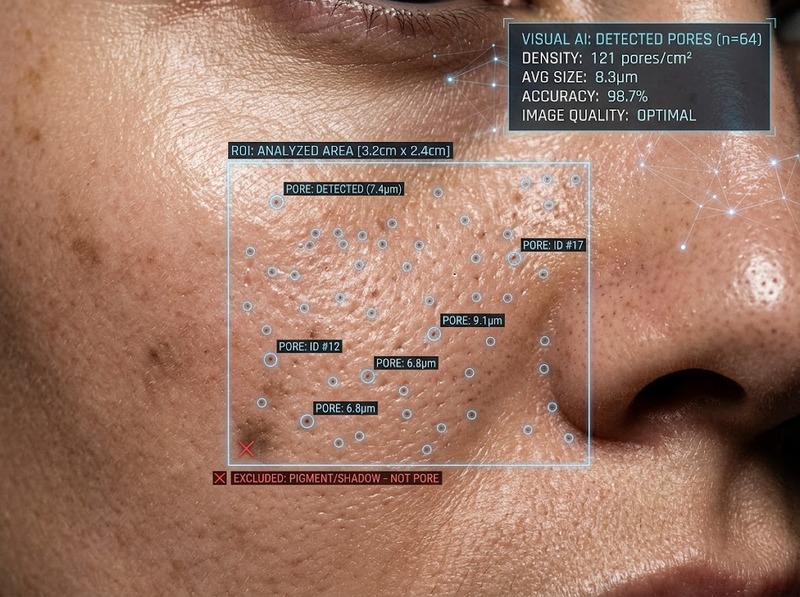
Kết quả cuối không được suy ra trực tiếp từ một pixel “tối”. Số lượng, kích thước hay mật độ chỉ được tính sau khi hệ thống xác định vùng da cần đo và tạo ra các điểm hoặc mặt nạ phân đoạn của lỗ chân lông. Vì vậy, độ phân giải, ánh sáng, khoảng cách chụp, góc mặt và vùng quan tâm (ROI) là một phần của phép đo, không chỉ là điều kiện chụp ảnh.
Từ ảnh khuôn mặt đến bản đồ lỗ chân lông
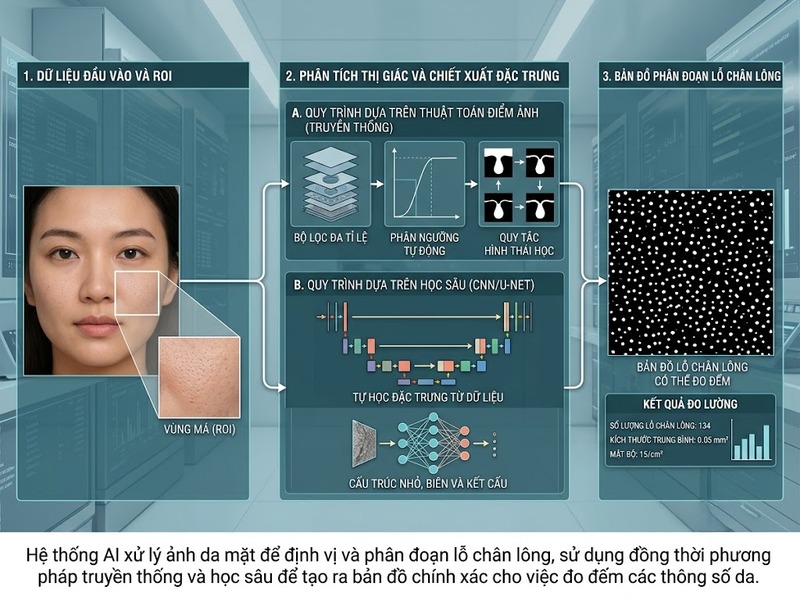
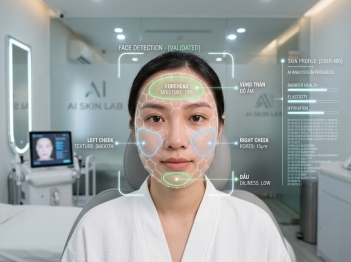
Một hệ thống AI nhận diện lỗ chân lông thường xử lý ảnh theo bốn công đoạn: xác định vùng da cần phân tích, làm nổi các cấu trúc có khả năng là lỗ chân lông, phân loại hoặc phân đoạn chúng, rồi hậu xử lý để tạo thành các đối tượng có thể đo. Đầu ra quan trọng của bước nhận diện vì thế chưa phải là “mật độ” hay “số lượng”, mà là bản đồ điểm, mặt nạ pixel hoặc danh sách vùng mà thuật toán gán cho lỗ chân lông.
Ở đầu chuỗi, ảnh thường được căn chỉnh theo khuôn mặt và giới hạn vào vùng quan tâm, chẳng hạn vùng má hoặc vùng chữ T. Cách làm này giảm phần ảnh không liên quan và giúp phép đo được áp dụng trên diện tích nhất quán hơn. Thuật toán sau đó tìm các biến đổi cục bộ về độ sáng, biên, kết cấu và hình thái. Với xử lý ảnh truyền thống, bước này có thể dùng bộ lọc nhiều thang, ngưỡng tương phản hoặc Difference of Gaussian (DoG). Với học sâu, CNN hoặc mạng phân đoạn kiểu U-Net học các mẫu thị giác trực tiếp từ dữ liệu huấn luyện.
Nghiên cứu của Sun và cộng sự về phân tích lỗ chân lông tự động sử dụng phát hiện đa tỉ lệ và chọn thang tối ưu trước khi trích xuất các đặc trưng như tổng diện tích, kích thước trung bình và số lượng. Một nghiên cứu học sâu công bố năm 2023 dùng kiến trúc U-Net kèm cơ chế attention để tạo bản đồ phân đoạn lỗ chân lông dựa trên cấu trúc hình thái của da. Dù kỹ thuật khác nhau, cả hai hướng đều phải định vị được vùng lỗ chân lông trước khi tính các chỉ số.
Không có một công thức duy nhất cho mọi ứng dụng. Ứng dụng điện thoại có thể dùng mạng nơ-ron đầu-cuối; thiết bị phân tích da có thể dùng chuỗi xử lý ảnh được hiệu chuẩn; hệ thống khác có thể kết hợp cả hai. Điểm chung vẫn là phát hiện tín hiệu thị giác phù hợp, loại nhiễu và chuyển kết quả thành cấu trúc có thể đo.
Vì sao lỗ chân lông thường hiện thành vùng tối nhỏ?
Trên ảnh 2D, lỗ chân lông thường được nhận ra trước hết nhờ độ tương phản cục bộ. Hướng dẫn kỹ thuật của VISIA mô tả lỗ chân lông là những cấu trúc có xu hướng tối hơn vùng da xung quanh do hiệu ứng bóng, đồng thời dùng màu tối và hình dạng gần tròn làm tín hiệu nhận diện. Vì vậy, “phát hiện vùng tối” mô tả đúng một phần cơ chế thị giác, nhưng vùng tối chỉ là đặc trưng tương đối chứ không phải định nghĩa của lỗ chân lông.
Thuật toán có thể so sánh độ sáng của một vùng nhỏ với nền xung quanh, tìm biến đổi tần số cao hoặc làm nổi cấu trúc dạng điểm bằng bộ lọc DoG. Trong mạng học sâu, các tầng tích chập học cách phản ứng với biên, kết cấu và tổ hợp mẫu phức tạp hơn thay vì chỉ kiểm tra một ngưỡng xám. PS-Net, công bố năm 2025, cũng khai thác đặc trưng tần số cao của lỗ chân lông và dùng cơ chế attention để nhấn mạnh nhóm đặc trưng này.
Một chấm tối vẫn có thể là sắc tố, lông, nếp nhỏ, bóng bề mặt hoặc nhiễu camera. Nếu chỉ lấy mọi pixel tối hơn một ngưỡng cố định, hệ thống dễ tăng nhận diện nhầm khi điều kiện chiếu sáng thay đổi. Vì thế, độ tối thường chỉ dùng để tạo vùng ứng viên; các bước sau còn xét kích thước, hình dạng, vị trí, biên và ngữ cảnh lân cận.
Cùng một vùng da có thể tạo bản đồ lỗ chân lông khác khi ánh sáng chiếu lệch hoặc bề mặt da bóng hơn, bởi tín hiệu đầu vào đã thay đổi trước khi mô hình suy luận. Thuật toán có thể giảm một phần ảnh hưởng này, nhưng không thể xem điều kiện chụp là yếu tố không liên quan.
Hình dạng và kích thước giúp AI loại nhầm ra sao?
Sau khi có vùng ứng viên, hình thái giúp phân biệt lỗ chân lông với những chi tiết da khác. Trên nhiều ảnh, lỗ chân lông hiện thành cấu trúc nhỏ, gần tròn hoặc oval, trong khi một đốm sắc tố có thể lớn hơn và có hình thái khác. VISIA phân biệt lỗ chân lông với spots một phần dựa trên kích thước; nghiên cứu ảnh 2D của Dissanayake và cộng sự còn mô tả lỗ chân lông theo kích thước, hình dạng, màu và hướng.
Với thuật toán truyền thống, hệ thống có thể đo diện tích pixel, độ tròn, tỉ lệ chiều dài–rộng hoặc độ tương phản ở biên, rồi loại những vùng quá lớn, quá nhỏ hoặc quá kéo dài so với tiêu chí đã đặt. Phát hiện đa tỉ lệ cho phép cùng một chuỗi xử lý tìm cấu trúc xuất hiện ở nhiều kích thước ảnh khác nhau: thay vì dùng một kích thước cố định, thuật toán kiểm tra phản ứng ở nhiều thang và chọn thang phù hợp.
Mạng học sâu không nhất thiết cần một quy tắc riêng như “độ tròn lớn hơn X thì giữ lại”. Nếu dữ liệu huấn luyện và nhãn đủ phù hợp, CNN có thể học đồng thời tổ hợp hình dạng, kết cấu, vị trí và độ tương phản từ nhiều ví dụ. Đây là khác biệt giữa đặc trưng do con người thiết kế trước và đặc trưng được mô hình học từ dữ liệu.
Hình dạng cũng không phải luật tuyệt đối. Lỗ chân lông thật có thể trông kéo dài theo hướng bề mặt da, thay đổi hình khi góc chụp khác đi hoặc chỉ hiện một phần khi độ phân giải không đủ. Quy tắc hình học quá cứng có thể giảm nhận diện nhầm nhưng đồng thời làm tăng bỏ sót. Vì vậy, hình dạng và kích thước nên là bằng chứng hỗ trợ cho quyết định nhận diện, không phải tiêu chuẩn duy nhất.
Từ vùng đã phát hiện đến số lượng, kích thước và mật độ
Khi đã có mặt nạ phân đoạn, việc tính chỉ số trở nên trực tiếp hơn. Mỗi vùng liên thông trên mặt nạ có thể được xem là một đối tượng ứng viên. Hệ thống đếm số đối tượng, tính số pixel của từng vùng, đo trục dài–ngắn hoặc đường kính tương đương, rồi tổng hợp thành kích thước trung bình, tổng diện tích hoặc phân bố kích thước. Nếu ảnh được hiệu chuẩn theo kích thước vật lý, diện tích pixel có thể quy đổi sang đơn vị thực; nếu không, kết quả chỉ nên được hiểu trong hệ tọa độ và thang của ảnh.
“Mật độ” là đại lượng suy ra từ số lỗ chân lông trên một diện tích tham chiếu. Cách đơn giản là lấy số đối tượng phát hiện được chia cho diện tích ROI hoặc diện tích quy ước. Chẳng hạn, cùng phát hiện 100 lỗ chân lông nhưng ROI 2 cm² và ROI 4 cm² sẽ cho mật độ khác nhau. Nếu mức phóng đại, vùng cắt hoặc thang ảnh thay đổi mà không được hiệu chỉnh, số đếm giữa hai lần chụp không còn trực tiếp tương đương.
Trong nghiên cứu năm 2019 sử dụng ảnh toàn mặt chụp bằng Visia-CR, kích thước lỗ chân lông do công cụ phân tích 2D tính có tương quan với đánh giá trực quan ở mức r = 0,86. Đây là hệ số tương quan trong bối cảnh nghiên cứu đó, cho thấy phép đo từ ảnh liên hệ khá chặt với visual grading; nó không phải “độ chính xác 86%” và không thể dùng làm mức chính xác chung cho mọi ứng dụng AI.
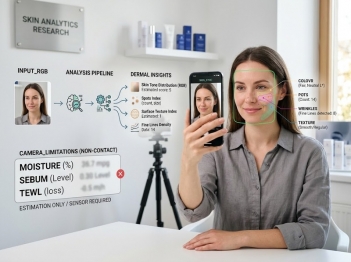
Cũng cần tách “độ sâu” khỏi những chỉ số rút ra trực tiếp từ ảnh 2D. Một số hệ thống có thể tạo điểm depth hoặc severity từ độ tối, hình thái hay mô hình đã học, nhưng một ảnh 2D đơn lẻ không tự cung cấp độ sâu hình học theo milimet. Muốn đo địa hình bề mặt theo nghĩa 3D cần dữ liệu hoặc thiết bị có khả năng tái tạo chiều sâu. Với nhận diện trên ảnh 2D, số lượng, diện tích, hình dạng và mật độ là các đại lượng trực tiếp hơn từ mặt nạ phân đoạn.
AI học sâu khác xử lý ảnh truyền thống ở điểm nào?
Xử lý ảnh truyền thống bắt đầu từ các đặc trưng do kỹ sư xác định trước. Một chuỗi xử lý có thể tăng tương phản, dùng DoG để làm nổi cấu trúc nhỏ, đặt ngưỡng, thực hiện phép toán hình thái rồi lọc đối tượng theo kích thước và độ tròn. Từng bước tương đối dễ giải thích và có thể tinh chỉnh riêng, nhưng ngưỡng tối ưu cho một kiểu ảnh có thể kém ổn định khi camera, ánh sáng hoặc màu da thay đổi.
Học sâu chuyển phần lớn việc thiết kế đặc trưng sang quá trình huấn luyện. CNN hoặc U-Net nhận ảnh và học các mẫu giúp dự đoán pixel nào thuộc lỗ chân lông; cơ chế attention có thể làm mạng tập trung hơn vào vùng hoặc đặc trưng quan trọng. Nghiên cứu năm 2023 về phân đoạn hình thái da báo cáo mô hình U-Net có attention định vị lỗ chân lông tốt hơn các phương pháp xử lý ảnh truyền thống được dùng làm đối chứng trong thí nghiệm của tác giả.
Ranh giới giữa hai hướng không tuyệt đối. PS-Net năm 2025 là một ví dụ về hệ thống lai: DoG được dùng để tạo nhãn thô, sau đó mạng học sâu tinh chỉnh phân đoạn bằng nhãn giả được cập nhật dần. Trong thực tế, chuẩn hóa ảnh, tiền xử lý và hậu xử lý hình thái vẫn có thể nằm trước hoặc sau một mạng nơ-ron.
Vì vậy, “AI” không có nghĩa mọi quy tắc xử lý ảnh truyền thống biến mất. Khác biệt cốt lõi là mức độ đặc trưng được lập trình thủ công so với mức độ được học từ dữ liệu. Học sâu có thể học tổ hợp mẫu phức tạp hơn, nhưng đổi lại cần dữ liệu đại diện, nhãn đủ tin cậy và kiểm thử trong điều kiện gần với lúc sử dụng.
Vì sao kết quả thay đổi giữa hai lần chụp?
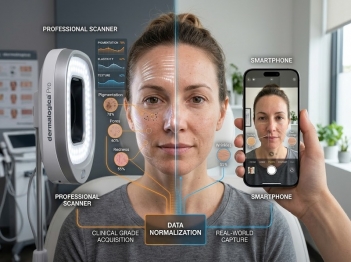
Kết quả nhận diện phụ thuộc cả mô hình lẫn ảnh đầu vào. Ánh sáng thay đổi làm độ tương phản và bóng quanh lỗ chân lông thay đổi; khoảng cách và tiêu cự thay đổi số pixel mà một lỗ chân lông chiếm; góc mặt làm hình học ROI biến dạng; bề mặt da bóng tạo vùng phản xạ có thể che hoặc làm lệch biên. Nếu ROI thay đổi, phép tính mật độ cũng thay đổi vì diện tích tham chiếu không còn giống nhau.
Các nghiên cứu kiểm định vì thế thường chuẩn hóa việc chụp. Một nghiên cứu so sánh năm 2024 sử dụng ảnh chính diện trong điều kiện ánh sáng đồng nhất rồi đối chiếu điểm lỗ chân lông của các mô hình với VISIA và đánh giá của bác sĩ da liễu. Trong nghiên cứu này, mô hình D sau cập nhật đạt 70,4% mức đồng thuận tổng thể với xếp hạng của bác sĩ; mức đồng thuận còn thay đổi theo nhóm phototype da và theo từng mô hình. Con số 70,4% chỉ mô tả nhiệm vụ xếp hạng cặp ảnh trong nghiên cứu đó, không phải độ chính xác phổ quát của công nghệ nhận diện lỗ chân lông.
Sự khác nhau giữa các nhóm da cho thấy dữ liệu huấn luyện và kiểm thử có ảnh hưởng trực tiếp đến khả năng tổng quát hóa. Một mô hình có thể hoạt động tốt trên tập ảnh đã được tối ưu nhưng giảm hiệu quả khi gặp phân bố màu da, thiết bị hoặc ánh sáng khác. Vì vậy, chất lượng hệ thống nên được xem xét cùng tính đại diện của dữ liệu và kết quả kiểm thử ngoài tập huấn luyện, thay vì chỉ dựa vào một lớp phủ nhận diện trông hợp mắt.
Nếu mục tiêu là theo dõi thay đổi theo thời gian, cần giữ điều kiện đo càng nhất quán càng tốt: dùng cùng thiết bị hoặc chế độ camera, ánh sáng tương tự, khoảng cách và góc chụp tương tự, cùng ROI và cùng chuỗi xử lý. Khi những biến này ổn định hơn, thay đổi về số lượng, kích thước hay mật độ có cơ sở tốt hơn để phản ánh khác biệt trên ảnh da thay vì khác biệt của lần chụp.
Cơ chế của AI nhận diện lỗ chân lông có thể tóm gọn thành ba lớp: nhận tín hiệu thị giác từ vùng da, xác định cấu trúc có hình thái phù hợp với lỗ chân lông, rồi đo các đối tượng đã được phân đoạn. Vùng tối giúp tạo ứng viên; hình dạng, kích thước, thang ảnh và ngữ cảnh giúp loại nhầm; mặt nạ cuối cùng là cơ sở để tính số lượng, diện tích và mật độ.
Giá trị của kết quả phụ thuộc đồng thời vào mô hình và chất lượng phép đo. Ảnh 2D có thể cung cấp các chỉ số hữu ích, nhưng chúng phải được hiểu trong điều kiện chụp, ROI, thang ảnh và dữ liệu huấn luyện cụ thể. Khi các điều kiện này được chuẩn hóa và thuật toán được kiểm định trên nhóm da đủ đa dạng, việc so sánh giữa các lần chụp mới có cơ sở tốt hơn.

GỬI Ý KIẾN BÌNH LUẬN